Two Agents Walk Into a Pull Request: Claude Code Agent Teams in der Produktion
Wie wir mit Claude Code Agent Teams Hunderte von API-Endpunkten einer Multi-Tenant-Healthcare-Plattform migrieren - mit einem KI-Kritiker, der den Merge blockiert, bis der Code eine binäre Qualitäts-Rubrik besteht. Architektur, Quality Gates, Kosten und die Lektionen aus dem Produktionseinsatz.
12 Min. Lesezeit
In diesem Artikel:
- Warum 310 Endpunkte von Hand zu migrieren keine Option war
- Warum ein einzelner Prompt (und ein einzelner Agent) nicht ausreicht
- Subagents vs. Agent Teams - zwei Orchestrierungsmuster in Claude Code
- Das Sequential-Duet-Modell: unsere sechsphasige Migrationspipeline
- Die 83%-Rubrik - ein Quality Gate mit harten Sicherheits-Caps
- Eine Knowledge Base, die jede Migration klüger macht
- Kosten, Zeiten und Lessons Learned
KI-Coding-Assistenten sind hervorragend darin, eine Funktion zu schreiben. Deutlich schwerer tun sie sich damit, einen sechsstufigen Engineering-Prozess mit Review, Compliance-Nachweisen und organisationalem Lernen zu betreiben. Dieser Artikel beschreibt, wie wir diese Lücke in einem echten Produktionsprojekt geschlossen haben: Zwei KI-Agenten - ein Entwickler und ein Kritiker - arbeiten gemeinsam an jeder Endpunkt-Migration, streiten über Codequalität und geben die Arbeit erst dann zum Merge frei, wenn der Kritiker grünes Licht gibt. Kein Mensch sitzt in dieser Schleife; Menschen prüfen das Ergebnis am Ende.
Das Setup läuft auf den Orchestrierungs-Features von Claude Code, einschließlich der experimentellen Agent Teams. Im Folgenden: die vollständige Architektur, das Quality Gate, das das System ehrlich hält, und was funktioniert hat - und was nicht.
Das Problem: 310 Endpunkte, ein sehr langes Jahr
Das Projekt ist das Flaggschiff-Produkt eines unserer Kunden: eine Multi-Tenant-Healthcare-Plattform mit acht Jahren Django-Geschichte. Die swagger.yaml listet 811 V2-API-Endpunkte, die auf eine neue V3-API migriert werden mussten.
Bevor wir Code anfassten, haben wir ein Discovery über beide Frontends (Angular und AngularJS) laufen lassen, um herauszufinden, welche Endpunkte tatsächlich aufgerufen werden. Das Ergebnis: Nur 310 Endpunkt-Methoden werden aktiv genutzt - der Rest ist tote Oberfläche, die kein Frontend berührt. Von diesen 310 ist die Komplexitätsverteilung: 23 Complex, 76 Medium und 211 Simple.
Selbst mit mehr als halbiertem Scope lag die naive Schätzung bei rund 310 Entwicklertagen - etwa 10,5 Entwicklermonaten repetitiver Arbeit mit hohem Risiko. Genau das ist der Moment, in dem man anfängt zu denken: Das muss sich automatisieren lassen.
Und das Risiko ist real. Jede Endpunkt-Migration ist ein eigenes Mini-Projekt:
- Research - Analyse des bestehenden ViewSets, Serializers, der Permissions, Filter und der Frontend-Nutzung.
- Baseline-Tests - Contract-Tests gegen das V2-Verhalten, damit V3 es nicht unbemerkt verändern kann.
- V3-Implementierung - Viewset, Serializer, URLs, Tests, Cache-Tier, Fehlerantworten nach RFC 7807.
- Quality Review - ein strukturiertes Code-Review, bevor irgendetwas weitergeht.
- Nachvollziehbarkeit - jeder Schritt hinterlässt einen Kommentar im Ticketsystem für Audit und Compliance.
- Knowledge-Base-Update - Erkenntnisse fließen zurück in die Pipeline.
Wer einen dieser Schritte auslässt, gefährdet eine mandantenfähige medizinische Anwendung.
Warum ein Prompt nicht reicht
Der erste Reflex ist naheliegend: der KI den ganzen Endpunkt geben und sagen “migrier das”. Das funktioniert nicht - aus vier Gründen:
- Das Kontextfenster läuft voll. Research plus Baseline-Tests plus Implementierung plus Review überschreiten in einer Session leicht 200k Tokens.
- Ein Gehirn, ein blinder Fleck. Ein Modell sagt sich nicht selbst “du hast den Security-Check vergessen”. In einer einzelnen Session gibt es keinen Gegenspieler.
- Keine Qualitätsschleife. Ein einzelner Agent akzeptiert seine eigene Arbeit. Es gibt keinen Mechanismus für echtes Peer Review.
- Keine Struktur heißt keine Nachweise. Kein Ticket-Trail, keine Knowledge-Base-Updates, keine Compliance-Spur. Die Arbeit passiert, die Evidenz nicht.
Die Schlussfolgerung, die alles Weitere geprägt hat: Man muss Struktur um das Modell herum bauen, die Qualität erzwingt - statt zu hoffen, dass ein längerer Prompt es richtet.
Claude Code ist nicht ein Claude - es ist eine Runtime
Claude Code wird meist als terminalbasierter Coding-Agent beschrieben: Man spricht mit ihm, er liest Dateien, editiert, führt Befehle aus. Er liest bei jedem Turn die CLAUDE.md - die “Projektverfassung” - neu, verbindet sich über MCP-Server mit externen Systemen (Ticketing, Git-Hosting, Datenbanken) und lädt modulare Markdown-Skills bei Bedarf.
Die zentrale Erkenntnis für dieses Projekt: Claude Code ist nicht ein Claude. Es ist eine Runtime, in der man viele orchestrieren kann. Es gibt zwei Orchestrierungsmuster - und wir brauchten beide.
Subagents: isolierte Worker
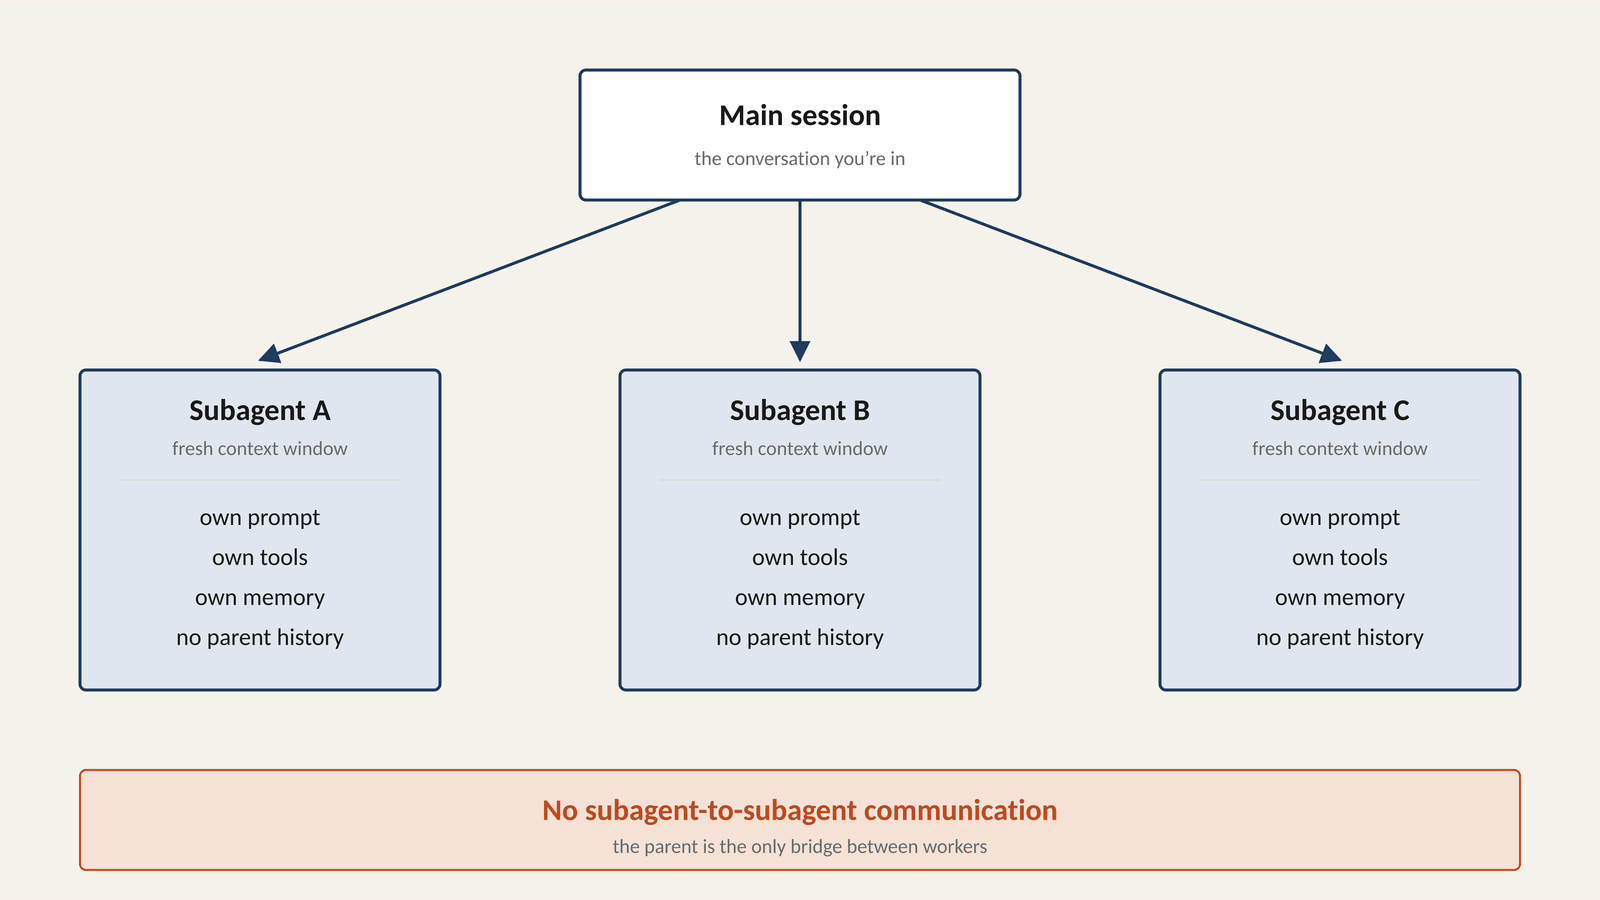
Subagents sind klassisches Fork-Join. Die Eltern-Session spawnt ein Kind, übergibt ihm einen Prompt, das Kind kommt mit einem Report zurück und beendet sich. Jedes Kind bekommt ein frisches Kontextfenster und sieht die Historie des Elternteils nie. Subagents werden als Markdown-Dateien in .claude/agents/ definiert - Name, Beschreibung, erlaubte Tools, welches Claude-Modell.
Entscheidend: Subagents wissen nichts voneinander. Spawnt man zwei parallel, ist die einzige Brücke zwischen ihnen der Parent. Diese Isolation ist ein Feature - eine geschwätzige Research-Aufgabe kann Tokens verbrennen, ohne den Hauptkontext zu verschmutzen, und nur die Zusammenfassung kommt zurück.
Für uns reichte das aber nicht. Unser Kritiker muss mit dem Entwickler in einer Schleife sprechen: “Stopp, das ist falsch, korrigiere es und komm zurück.” Dieses Gespräch lässt sich nicht durch einen Parent-Flaschenhals führen.
Agent Teams: Peers, die streiten
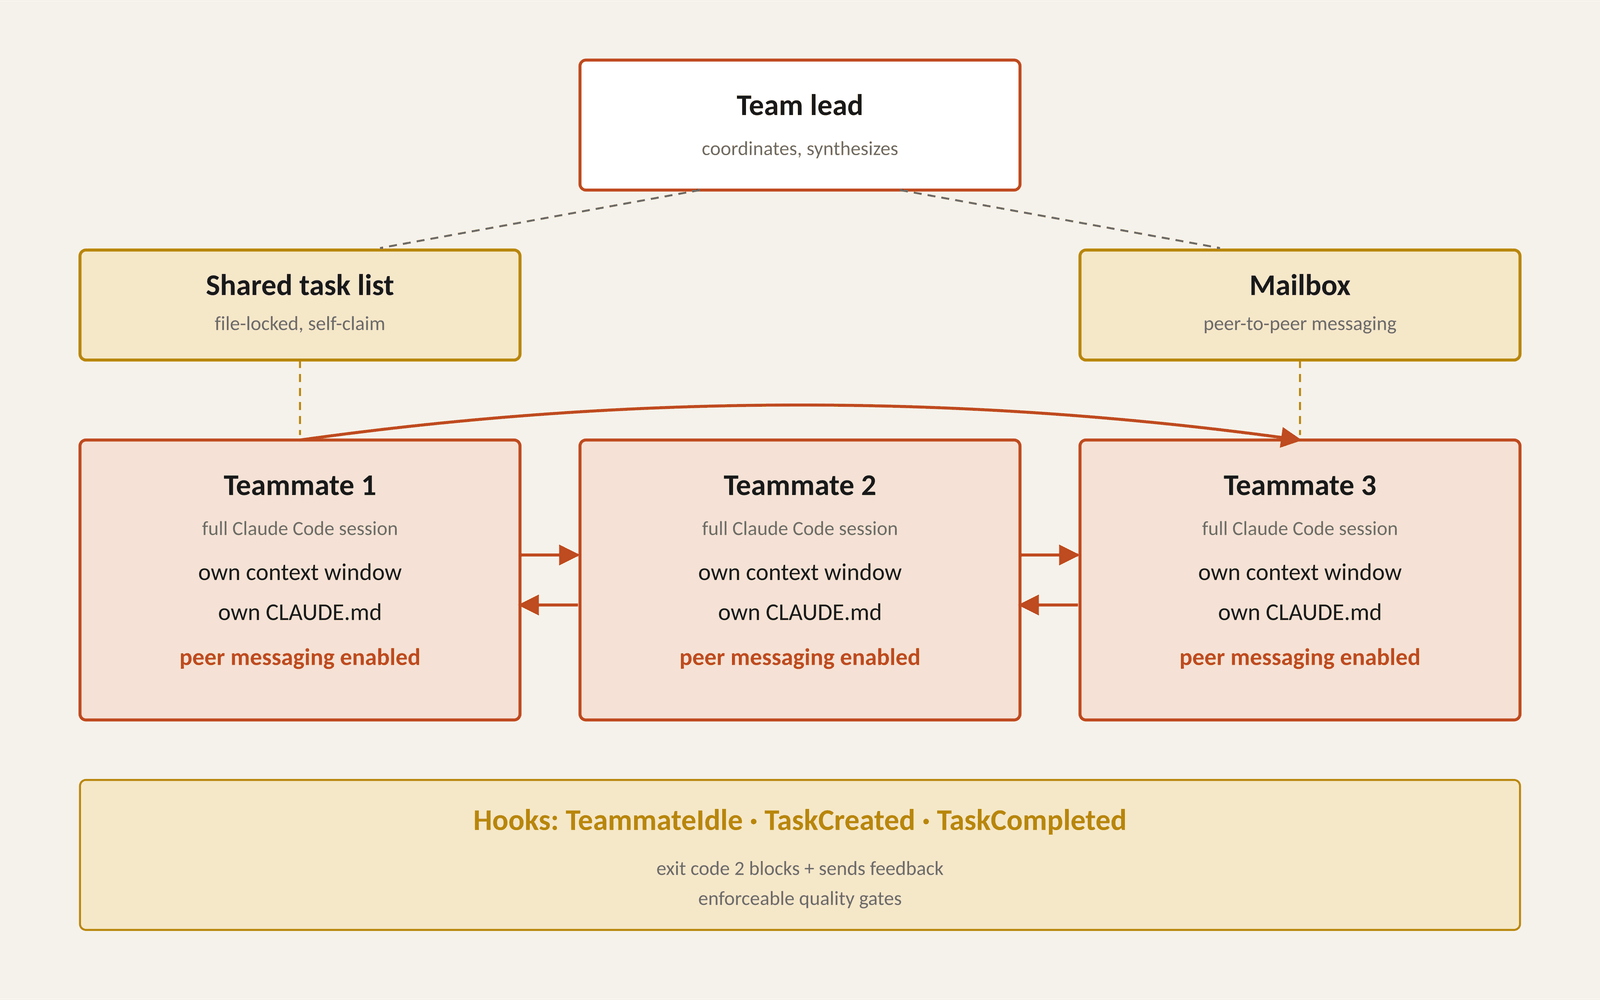
Agent Teams - ein experimentelles Claude-Code-Feature hinter einem Settings-Flag - ändern die Topologie. Statt eines Parents mit Kindern gibt es einen Team Lead mit gleichberechtigten Teammates. Der Lead koordiniert und synthetisiert, ist aber kein Kommunikations-Flaschenhals: Teammates schreiben sich direkt über eine Mailbox. Eine gemeinsame, file-gelockte Task-Liste verhindert Race Conditions, und Hooks (TeammateIdle, TaskCreated, TaskCompleted) bieten Ansatzpunkte, um Quality Gates zu erzwingen.
Ein elegantes Detail verbindet beide Welten: Ein Teammate kann eine Subagent-Definition wiederverwenden. Dieselbe Datei v3-critic.md dient in einer Phase als Subagent und in einer anderen als Teammate. Eine Identität, zwei Ausführungsmodi.
Was beim Spawn eines Teammates wirklich geladen wird
Diesen Teil sollte man sich merken, denn die Intuition ist falsch. Es fühlt sich so an, als würde der Team Lead einen neuen Teammate mit Kontext “briefen”. Tut er nicht. Ein Teammate startet bei null.
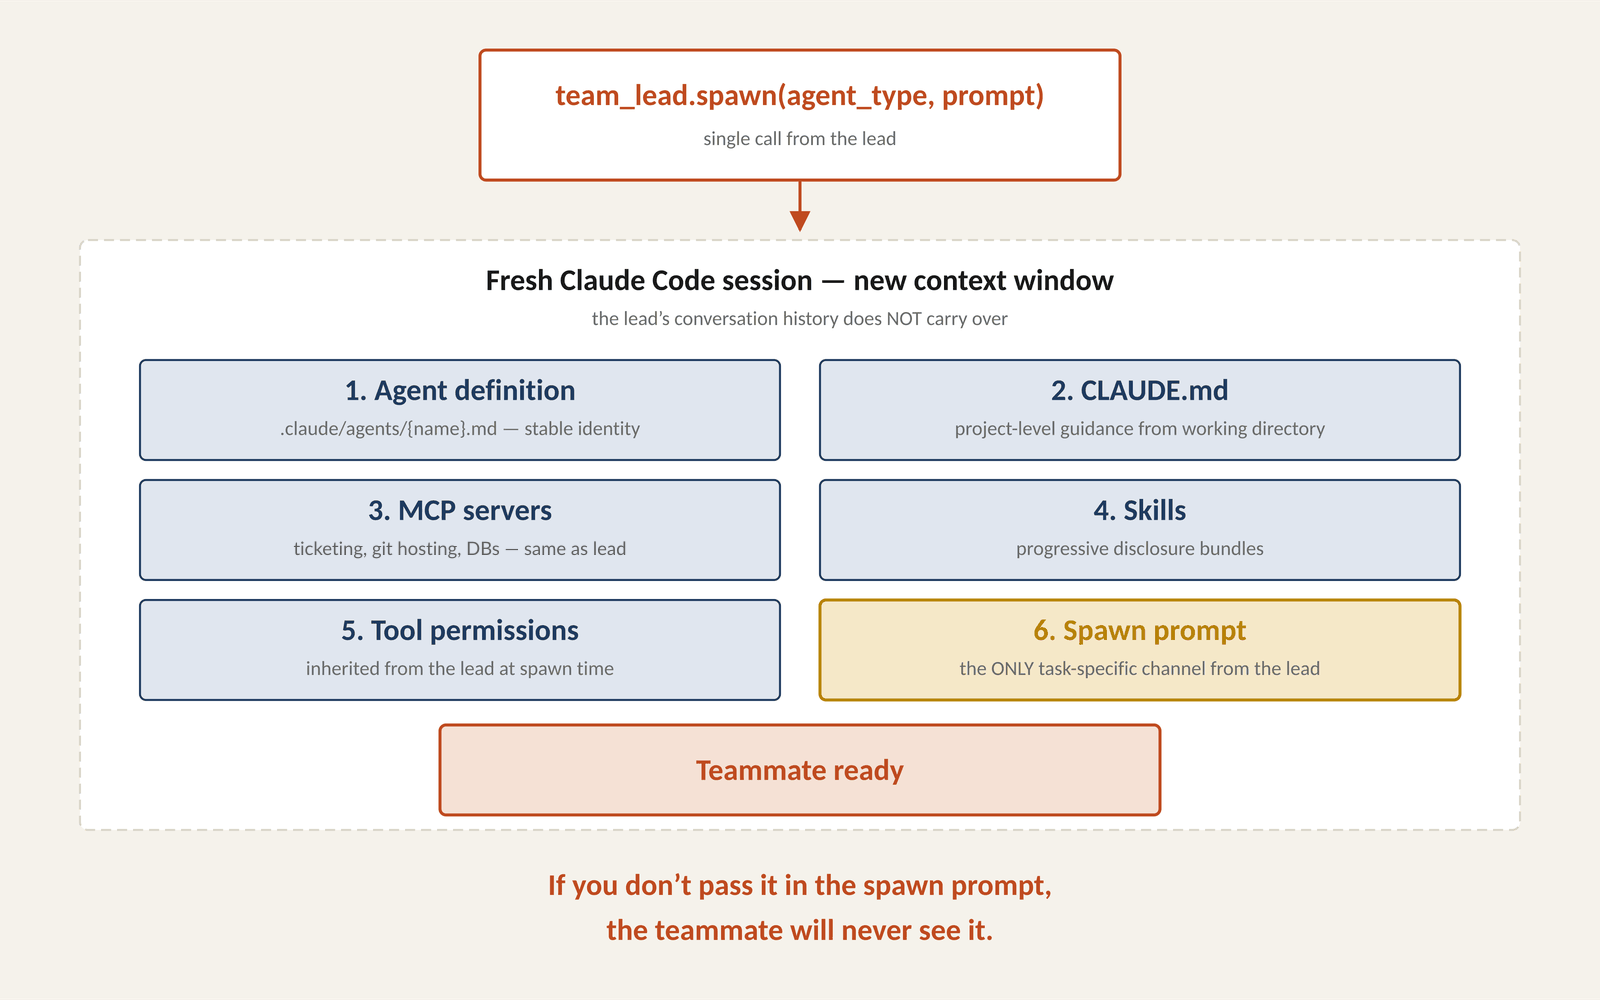
Das Kontextfenster eines frisch gespawnten Teammates enthält genau sechs Dinge: die Agentendefinition, die CLAUDE.md des Projekts, die MCP-Server, die Skills, vom Lead geerbte Tool-Berechtigungen - und den Spawn-Prompt. Nur der Spawn-Prompt ist aufgabenspezifisch. Alles andere ist statischer Projektzustand.
Die Konsequenz ist gewaltig: Wenn die Research-Phase herausgefunden hat, dass ein bestimmtes ViewSet auf einen eigenen Permissions-Helper angewiesen ist, und man dann den Kritiker spawnt - dann weiß der Kritiker das nicht, es sei denn, man schreibt es in den Spawn-Prompt. Unser Pipeline-Skill hat einen ganzen Abschnitt “Spawning the team”, der auflistet, was der Orchestrator jedem Agenten mitgeben muss. Das ist keine Bürokratie, das ist Physik: Was nicht im Spawn-Prompt steht, wird der Teammate nie sehen.
Subagents vs. Agent Teams im Überblick
| Aspekt | Subagents | Agent Teams |
|---|---|---|
| Modell | Fork-Join: Parent -> Child -> Report | Peer-to-Peer: Teammates sprechen direkt |
| Sessions | 1 Claude-Code-Session | N Sessions (Lead + N Teammates) |
| Kommunikation | nur über den Parent | Direktnachrichten + Mailbox-Broadcast |
| Kontext | eigenes Fenster, keine Parent-Historie | eigenes Fenster, keine Lead-Historie |
| Token-Kosten | niedriger - nur die Zusammenfassung kommt zurück | höher - jeder Teammate ist eine volle Session |
| Am besten für | Research, isolierte Lookups | Peer Review, konkurrierende Hypothesen |
| Reifegrad | stabil, produktionstauglich | experimentell |
Die Frage ist nie “was ist besser” - sondern “was wofür”.
Unsere Architektur: das Sequential-Duet-Modell
Jede Migration startet mit einem einzigen Slash-Befehl auf ein Ticket. Der Orchestrator - die Haupt-Claude-Code-Session - liest den Pipeline-Skill und führt sechs Phasen aus, jede in einem anderen Ausführungsmodus:
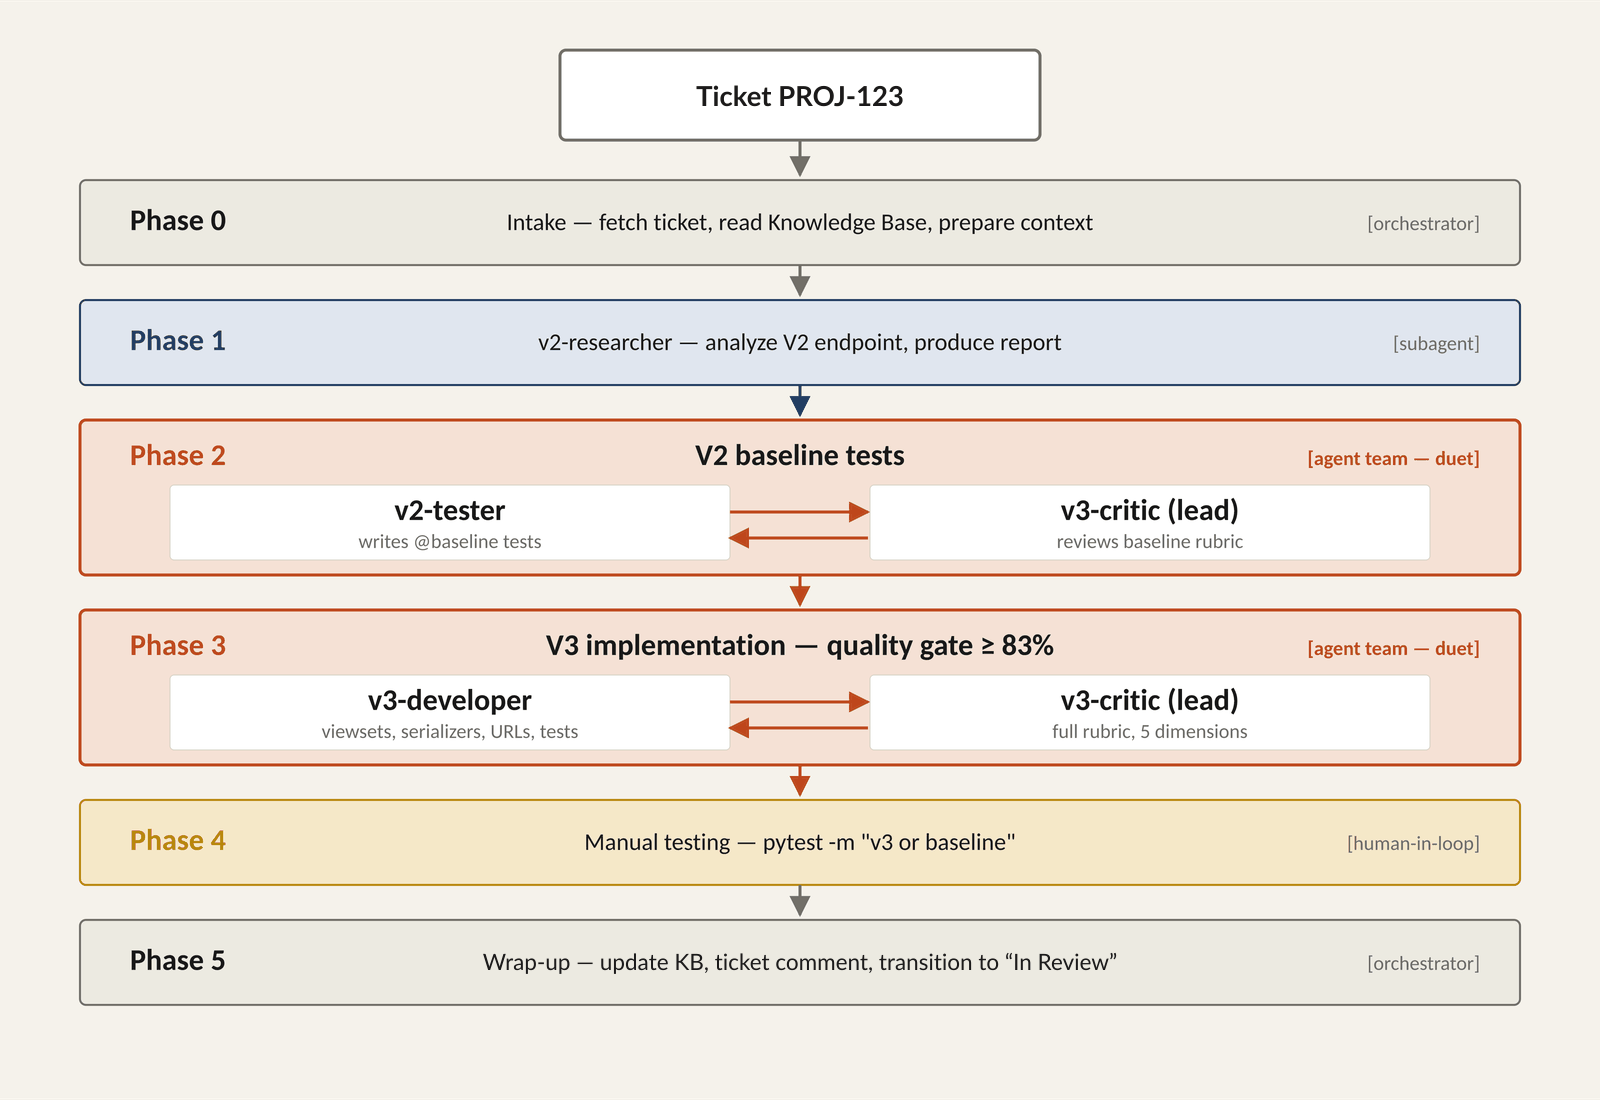
- Phase 0 - Intake (Orchestrator): Ticket holen, Knowledge Base lesen, Kontext vorbereiten.
- Phase 1 - Research (Subagent):
v2-researcheranalysiert den V2-Endpunkt und erstellt einen Report. Geschwätzige Dateilese-Arbeit, nur die Zusammenfassung zählt - ein perfekter Subagent-Job. - Phase 2 - Baseline-Tests (Agent Team - Duett):
v2-testerschreibt Contract-Tests gegen das V2-Verhalten;v3-criticprüft sie als Team Lead gegen eine Baseline-Rubrik. Das Duett iteriert, bis der Kritiker freigibt, dann löst sich das Team auf. - Phase 3 - V3-Implementierung (Agent Team - Duett):
v3-developerimplementiert Viewsets, Serializer, URLs und Tests; derselbe Kritiker - dieselbe Definitionsdatei, frische Session, neues Team - prüft gegen die volle Rubrik. Wieder: iterieren, freigeben, auflösen. - Phase 4 - Manuelles Testen (Mensch): Die Pipeline stoppt und bittet einen Menschen, die V3- und Baseline-Testsuiten auszuführen.
- Phase 5 - Wrap-up (Orchestrator): Knowledge Base aktualisieren, finalen Ticket-Kommentar hinterlassen, Ticket in den Review-Status überführen.
Jede Phase hinterlässt einen Kommentar im Ticket. Geht etwas schief, enthält das Ticket einen vollständigen Audit-Trail, wer was in welcher Phase getan hat - Compliance-Teams lieben das, und es kostet uns nichts.
Die Docker-Wand: warum sequenziell statt parallel
Eine teure Lektion steckt im Namen des Modells. Unsere erste Version ließ die beiden Teams gleichzeitig laufen - und sie kamen sich in die Quere. Sowohl v2-tester als auch v3-developer führen pytest in derselben Docker-Umgebung aus: Datenbankkonflikte, Portkollisionen, blockierte Prozesse, Cache-Verschmutzung. Einen halben Tag Debugging später stand die Regel: sequenzielle Duette, keine parallelen Teams. Das Team aus Phase 2 muss sich vollständig auflösen und aufräumen, bevor das Team aus Phase 3 spawnt. Parallelisieren, wo der Zustand isoliert ist; serialisieren, wo er kollidiert.
Das Quality Gate: eine 83%-Rubrik mit harten Caps
Das Herz des Systems: Der Kritiker bewertet nicht subjektiv. Er arbeitet eine binäre Rubrik ab - jeder Checkpoint ist bestanden oder nicht bestanden, kein Bauchgefühl - über fünf gewichtete Dimensionen:
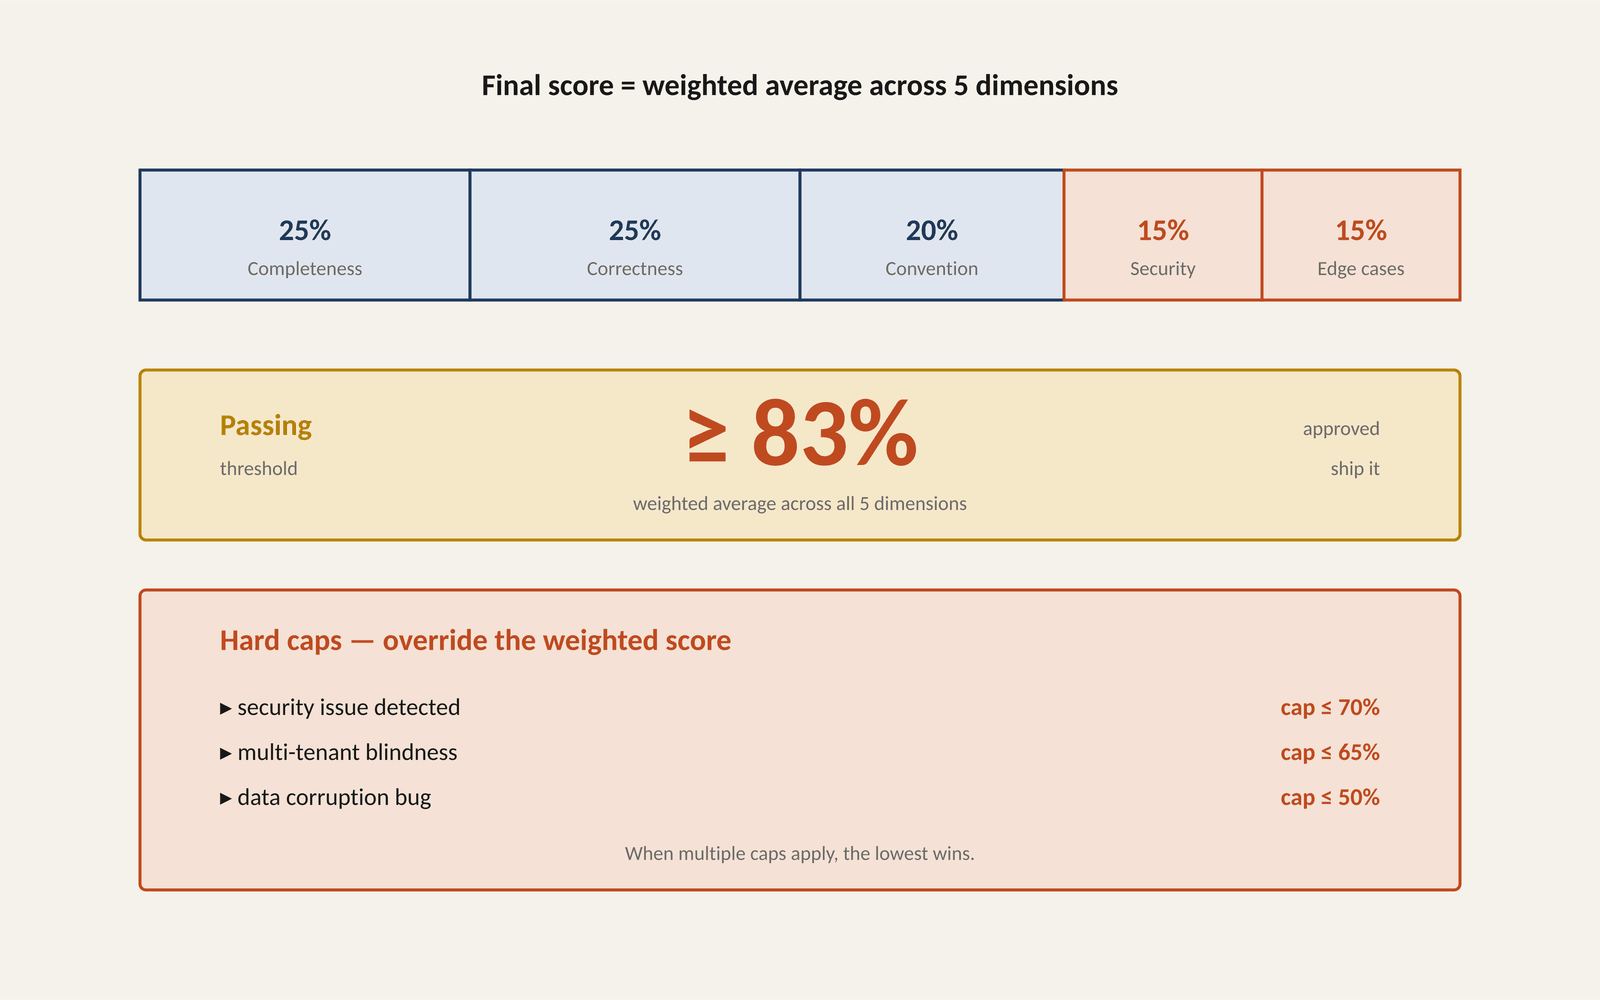
- Completeness (25%) - alle HTTP-Methoden, Custom Actions, Response-Shapes.
- Correctness (25%) - Fehlerantworten, Validatoren, Cache-Tier.
- Convention (20%) - Dateiablage, Basisklassen, Projektidiome.
- Security (15%) - Permissions, Prüfungen der Mandantenisolation.
- Edge Cases (15%) - Pagination, leere Zustände, Grenzverhalten.
Die Bestehensschwelle liegt bei 83% - ein konfigurierbarer Parameter in der Rubrik-Datei, keine magische Zahl. Lässt das Gate fehlerhaften Code durch, erhöhen wir sie; blockiert es zu oft den Fortschritt, senken wir sie.
Wichtiger als die Schwelle sind die harten Caps, die den gewichteten Score schlicht übersteuern:
- Sicherheitsproblem erkannt -> Score gedeckelt auf 70%
- Multi-Tenant-Blindheit -> gedeckelt auf 65%
- Datenkorruptions-Bug -> gedeckelt auf 50%
Greifen mehrere Caps, gewinnt der niedrigste. In der Praxis heißt das: Eine wunderschön vollständige Implementierung mit einem Sicherheitsloch kann sich niemals über Completeness-Punkte am Gate vorbeischleichen.
Noch eine bewusste Entscheidung: Der Kritiker läuft auf Claude Opus, die Worker (Researcher, Tester, Developer) laufen auf Claude Sonnet. Der Kritiker muss sich festbeißen und sein Urteil verteidigen können; die Worker brauchen vor allem Durchsatz. Diese Aufteilung ist unser Sweet Spot aus Kosten und Qualität.
Die Pipeline, die lernt
Claude hat kein Gedächtnis zwischen Läufen - jede Migration startet mit leerem Kontext. Aber das Projekt erinnert sich, denn die Knowledge Base ist eine Markdown-Datei im Repository.
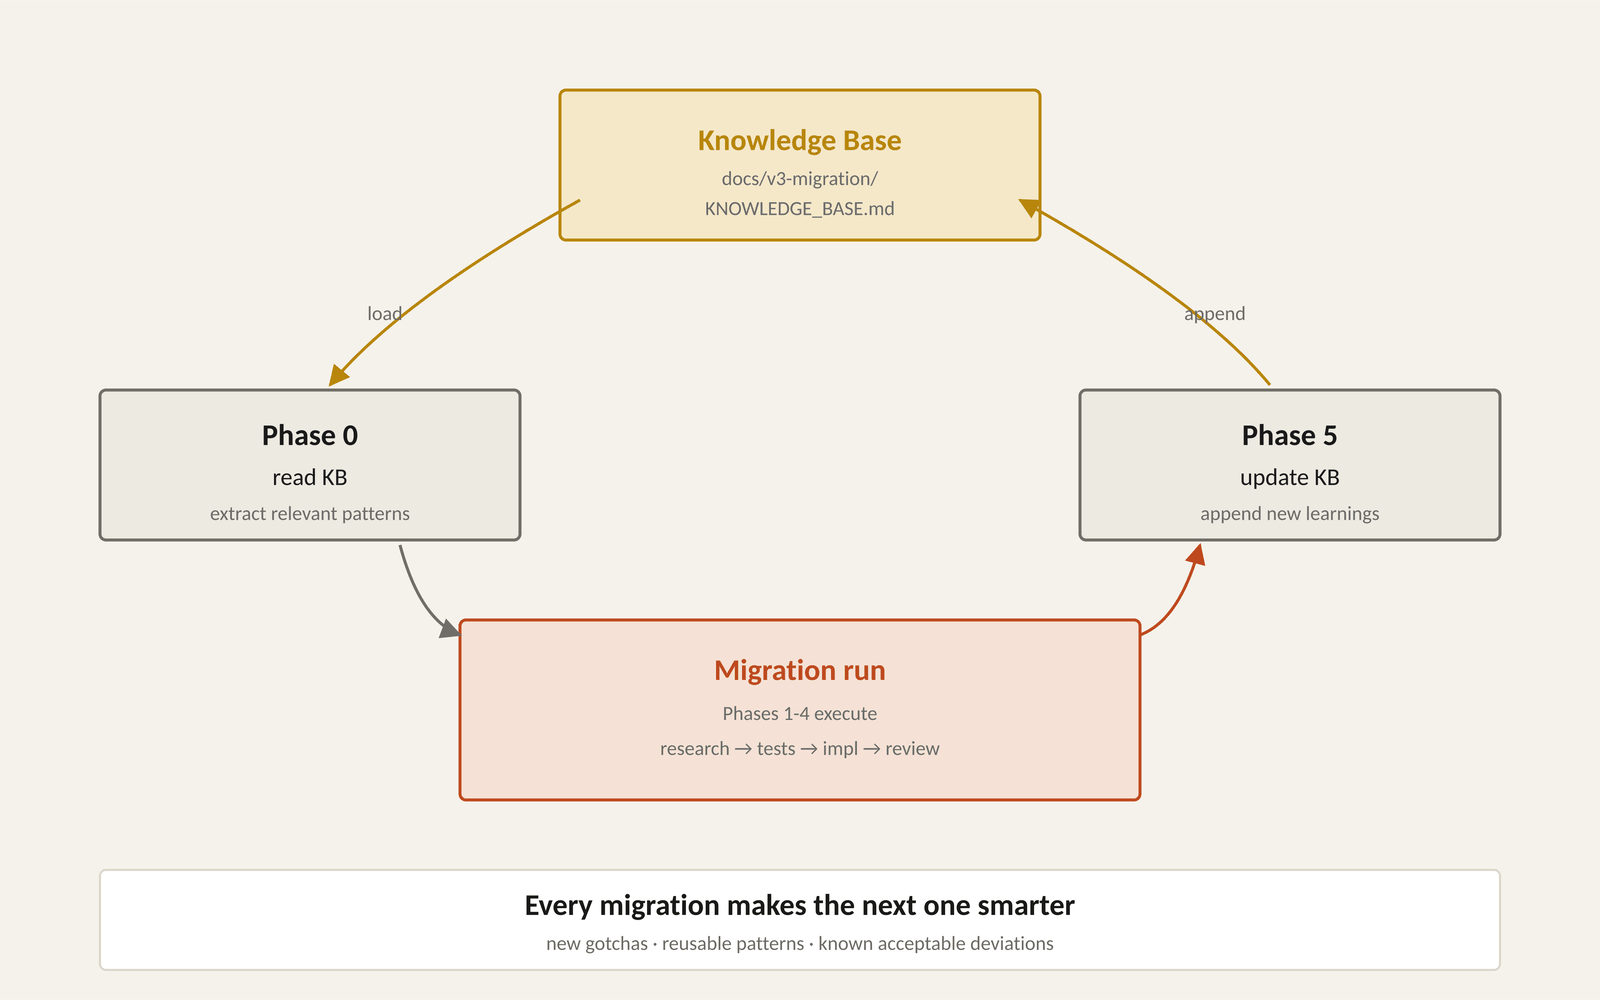
Jeder Lauf liest die KB in Phase 0 und extrahiert die für seinen Endpunkt relevanten Patterns. In den Phasen 1-4 entdecken die Agenten neue Gotchas, Patterns und akzeptierte Abweichungen (“für diesen Endpunkt-Typ weichen wir von Konvention X ab, weil Y”). In Phase 5 werden diese Erkenntnisse angehängt. Der nächste Lauf startet von einer höheren Basis.
Nach zehn Migrationen hat die KB etablierte Konventionen, die kein Lauf mehr neu erfinden muss. Nach fünfzig ist sie fast ein vollständiger Onboarding-Guide für einen neuen Entwickler - organisationales Lernen, das gratis passiert, als Nebeneffekt des Auslieferns.
Was es kostet und wie lange es dauert
- Kosten pro Endpunkt: etwa 1-3 USD an Tokens (Opus für den Kritiker, Sonnet für den Rest). Für alle 310 aktiven Endpunkte landet man im Bereich weniger hundert Dollar - gegenüber einer naiven Schätzung von ~310 Entwicklertagen.
- Laufzeit: 15-40 Minuten für einen einfachen CRUD-Endpunkt, 60-90 Minuten für einen mit vielen Custom Actions. Die meiste Zeit geht in die Entwickler-Kritiker-Iterationen - genau dorthin, wo wir sie haben wollen.
- Sicherheit: Die Pipeline arbeitet auf einem Feature-Branch, und der Kritiker hat keine Merge-Rechte. Nichts erreicht den Main-Branch ohne menschliches Review, und Phase 4 hält einen Menschen in der Schleife, bevor ein PR geöffnet wird.
Lessons Learned
- Struktur schlägt Prompting. Eine binäre Rubrik schlägt jeden langen, eloquenten Prompt.
- Rollentrennung erzeugt Qualität. Der Entwickler darf nicht sein eigener Kritiker sein.
- Stabile Agentenidentität zahlt sich aus. Eine Markdown-Definition, wiederverwendet als Subagent und Teammate.
- Hybrid schlägt Purismus. Orchestrator, Subagents, Teams und Menschen je Phase mischen - kein Muster überall erzwingen.
- Sequenziell, wo Zustand kollidiert. Die Docker-Wand bestimmt alles um sie herum.
- Die Knowledge Base ist der Burggraben. Lernen verzinst sich von Lauf zu Lauf.
- Ein Ticket-Trail ist ein kostenloser Audit-Trail. Compliance-Evidenz als Nebeneffekt der Orchestrierung.
- Opus für Urteilskraft, Sonnet für Durchsatz. Tokens dort ausgeben, wo Sturheit zählt.
Und ein ehrlicher Vorbehalt: Agent Teams sind ein experimentelles Feature. Sie haben raue Kanten, und dieses Setup funktioniert bei uns, weil wir eine klare, mechanisch prüfbare Rubrik dafür haben, was “gut” bedeutet. Das ist eine Unterstützung für Engineers, kein Ersatz - die Menschen sind eine Ebene nach oben gerückt: vom Schreiben jeder Zeile zum Entwerfen des Systems, das sie schreibt.
Wenn Sie vor Ihrem eigenen Berg repetitiver, aber riskanter Engineering-Arbeit stehen - eine Framework-Migration, ein API-Versionssprung, Testabdeckungs-Schulden - lohnt es sich, dieses Muster zu übernehmen. Und wenn Sie dabei Unterstützung möchten: genau das ist unser Geschäft.