Minus 2.000.000 Zeilen PHP: Wie wir unsere Website mit Claude Code neu gebaut haben
Wir haben kyotutechnology.com von WordPress auf Astro 7 umgeschrieben - vollständig mit Claude-Code-Agenten, dynamischen Workflows und pixelgenauer Verifikation. Ein einziger Commit entfernte über 2 Millionen Zeilen WordPress, die Seite sieht identisch aus, behält jede URL, erreicht 99/100 bei PageSpeed mobil und kostet 0 $ im Betrieb. So hat es wirklich funktioniert - mit allen Zahlen.
9 Min. Lesezeit
In diesem Artikel:
- Ein einziger Cut-over-Commit entfernte 2.088.895 Zeilen (den gesamten WordPress-Baum) und fügte 117.883 neue hinzu - die finale Migrationssession dauerte 105 Minuten und brauchte 4 menschliche Prompts.
- Die Methode war ein System, kein Chat: ein CLAUDE.md-Projektgehirn, dynamische Multi-Agenten-Workflows und 13 paketierte Skills.
- KI verifizierte KI: 236 Seiten pixelweise mit der Produktion verglichen, 6.762 Crop-Diffs in 32 Cluster gruppiert, 24 chirurgische Fixes - einer davon korrigierte 231 Seiten auf einmal.
- SEO-Kontinuität wurde konstruiert, nicht erhofft: URLs 1:1, hreflang, Meta-Tags, JSON-LD und 64 generierte 301-Redirects, alles in der CI validiert.
- Inhalte werden jetzt per Prompt in Claude Code Web bearbeitet - Branch, PR, automatische Preview-URL, menschliches Review, Merge. Ohne IDE, ohne CMS, ohne Entwickler.
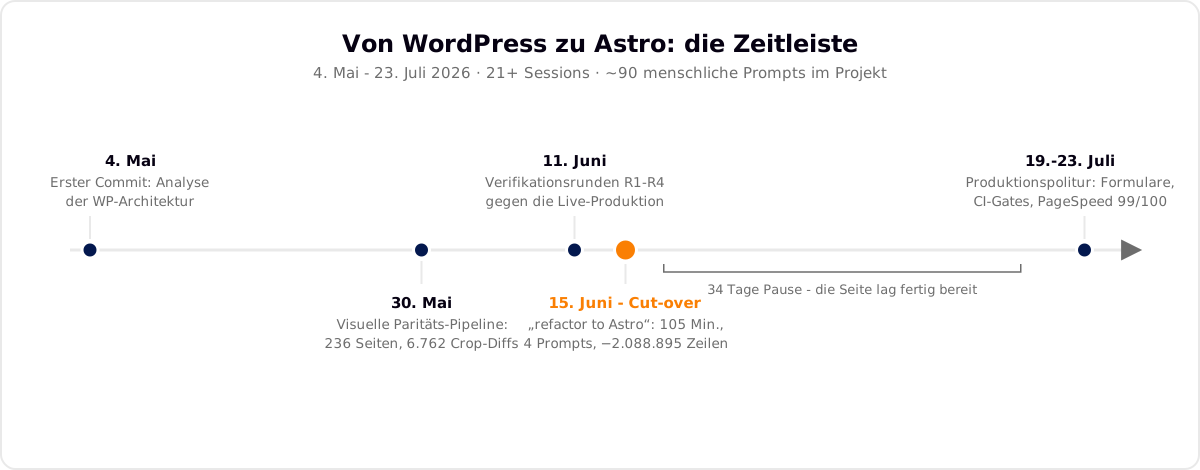
Unsere Firmenwebsite hat kein Backend mehr. Kein WordPress, kein PHP, kein MySQL, kein Plugin-Zoo, den man am Sonntagabend patchen muss. Ein Commit - 779d02f5, „refactor to Astro” - berührte 14.917 Dateien, fügte 117.883 Zeilen hinzu und entfernte 2.088.895. Die gelöschten Zeilen waren, um fair zu bleiben, größtenteils der WordPress-Baum selbst: Core, Plugins, Theme, Vendor-Code. Genau das war der Punkt. Der Cut-over war das Feature.
Was diese Geschichte erzählenswert macht, ist nicht der Framework-Wechsel. Es ist die Tatsache, dass die gesamte Migration - Analyse, Code, visuelle Verifikation, SEO-Kontinuität, Performance-Tuning - mit Claude Code durchgeführt wurde: KI-Agenten, orchestriert durch Workflows, verifiziert durch andere Agenten, überprüft und entschieden von Menschen. Die finale Migrationssession dauerte 105 Minuten und enthielt genau 4 menschliche Prompts. (Um ehrlich zu sein: Das war die finale Session. Das gesamte Projekt umfasste über 21 Sessions und rund 90 menschliche Prompts seit Ende Mai.)
Der Ausgangspunkt und die zwei nicht verhandelbaren Bedingungen
Vorher: ein klassischer WordPress-Stack - WPML für Englisch und Deutsch, ACF, Yoast, eine Sammlung von Plugins, ein PHP+SCSS-Theme, MySQL. Und die klassischen Schmerzen: Hosting-Rechnungen, Updates und Sicherheitslücken, die man im Blick behalten muss, langsames TTFB, gerettet durch Caching-Plugins, Bearbeitung über wp-admin.
Für den Neubau haben wir zwei harte Bedingungen gesetzt:
- Die Seite muss identisch aussehen. Pixel-Parität mit der Produktion, nicht „nah genug dran”.
- Null SEO-Verlust auf technischer Ebene. Dieselben URLs (inklusive Trailing Slash), hreflang, Meta-Tags, JSON-LD und eine 301-Map für jede Legacy-Slug-Variante.
Nachher: Astro 7 (gestartet sind wir mit 6, im Projektverlauf aktualisiert), vollständig statischer Build. Inhalte liegen in Markdown mit schema-validierten Content Collections (Zod). Der Build erzeugt über 250 statische Seiten - Englisch im Root, Deutsch unter /de/, mit einer Architektur, die ohne Umbau für weitere Sprachen bereit ist. Das Hosting zog auf Cloudflare Workers Static Assets um: ausgeliefert von der Edge, mit kostenlosen und unlimitierten Requests für statische Assets. Es gibt kein Backend im klassischen Sinne - nichts zu hacken, nichts zu patchen.
Methode: ein System, kein Chat
Das war kein „Chatten mit einer KI”. Es war ein System aus drei Bausteinen.
CLAUDE.md - das Gehirn des Repositorys. Es dokumentiert die Architektur, die Verifikationsbefehle, was nicht angefasst werden darf, und - entscheidend - eine Liste von Dingen, die wie Bugs aussehen, aber keine sind: zufällige „Related Posts” (orderby=rand), Inhalte hinter Hover-Zuständen oder display:none, die Grenzen der Textvergleichsfenster. Jede Session und jeder Agent startet mit diesem Kontext, statt zu raten.
Dynamische Workflows - skriptgesteuerte Orchestrierung vieler Agenten gleichzeitig, mit deterministischen Phasen, Schleifen und Fan-out: parallele Seitenanalyse und -migration, Diagnose->Fix->Re-Render->Compare-Schleifen, Vision-QA, bei der ein Modell buchstäblich Screenshots betrachtet, und ein Build-Verifikations-Gate nach jeder Phase.
Skills - 13 paketierte Prozeduren im Repository. Sechs sind Content-Operationen für nicht-technische Personen (neuer Blogpost, Seiteninhalt bearbeiten, neues Case Study, Stellenangebote, Team-Verwaltung, digitale Visitenkarten), sieben sind technisch (Astro, SEO, Performance, Core Web Vitals, Accessibility, Best Practices, Quality Audit).
Das verbindende Prinzip: Menschen entscheiden und reviewen - Agenten führen aus, verifizieren und berichten. Vertrauen entsteht aus Verifikationsschleifen, nicht aus Glauben an ein Modell.
KI verifiziert KI: die visuelle Paritäts-Pipeline
Das interessanteste Engineering-Artefakt des Projekts ist der geschlossene Audit->Fix->Verify-Zyklus, der die Pixel-Parität erzwungen hat:
- Produktions-Mirror. Ein lokaler Server, der eine gespiegelte Kopie der Live-WordPress-Seite als Wahrheitsquelle für Aussehen und Inhalt ausliefert.
- Screenshot-Paare. Puppeteer mit 16 parallelen Headless-Browsern rendert dieselbe Seite auf Produktion und in Astro, Desktop und Mobil. Der erste vollständige Scan verglich 236 Seiten in 214 Sekunden Renderzeit: 92 OK, 109 minor, 34 major, 1 critical.
- Diff und Clustering. 6.762 Crop-Diffs (1,2 GB), zerlegt in atomare Unterschiede; 79 einzigartige strukturelle Seitensignaturen, gruppiert in 32 Cluster mit identischen Diff-Signaturen - ein „flexible”-Cluster umfasste zum Beispiel 73 Blogposts mit demselben Sektionslayout. Einmal pro Cluster diagnostizieren, nicht einmal pro Seite.
- Agentenbasierte Diagnose. Ein Agent pro Seite liest die Diff-Daten und die Bildausschnitte und klassifiziert jedes Unterschieds-Atom: echter Defekt oder bekanntes Artefakt. Danach ein adversarialer Verifikationsdurchlauf - 25 unabhängige Bestätigungen der Root-Cause-Gruppen plus Bewertung des Regressionsrisikos - und ein synthetisierter Fix-Plan. In der Spitze liefen im Diagnose-Workflow 79 Agenten, einer pro Seitensignatur, jeder mit eigenem 1M-Token-Kontext.
- Chirurgische Fixes. 24 freigegebene Fixes: 15 Root-Cause- und 9 seitenspezifische, sequenziell angewendet ohne Dateikollisionen. Der Hebel des Root-Cause-Denkens: Die Korrektur einer einzigen globalen Body-Textfarbe (
#060112vs. Bootstraps Reboot#212529) reparierte 231 Seiten auf einmal; ein Fix für das kollabierte Bootstrap-Grid reparierte 120 Seiten; ein einziger Hero-Schriftgrößen-Fix deckte 92 Technologie-Seiten ab. - Vorher/Nachher-Messung. Ein vollständiges Re-Rendering aller 236 Seiten und ein deterministischer Vergleich: 156 Seiten verbessert, 79 unverändert, exakt 1 Regression - die eine begrenzte „Repair until dry”-Schleife auslöste.
- Ein separater Track für Interaktivität. Tabs, Stepper, Slider, Akkordeons, Filter und Formulare wurden aus dem JavaScript des WordPress-Themes in Vanilla-JS-Module portiert - ein Agent pro Komponente parallel, verifiziert durch echte Klicks gegen einen Dev-Server mit der Anforderung, dass der Ausgangszustand der Produktion entspricht.
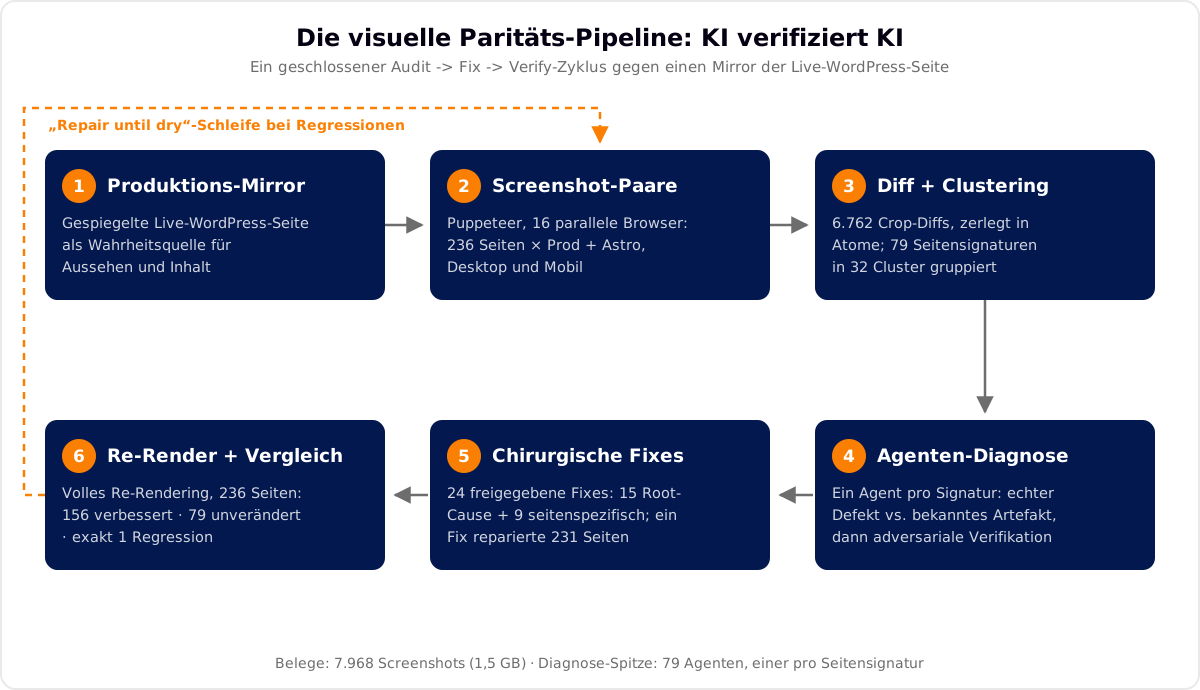
Das Beweisverzeichnis enthielt am Ende 7.968 Screenshots - 1,5 GB an Belegen, dass die neue Seite aussieht wie die alte.
SEO-Kontinuität, konstruiert
Parallel zum visuellen Track lief ein einfacherer, skriptgetriebener Content-Track:
- Ein Quell-Inventar aus der WordPress-Datenbank: 225 Seiten und Posts, 220 Sitemap-URLs, 55 Team-Einträge - gegen die Sitemap abgeglichen mit null Abweichungen in beide Richtungen.
- Ein Content-Paritätsbericht, der Texte Seite für Seite zwischen dem Astro-Build und dem Produktions-HTML vergleicht.
- 64 generierte 301-Redirects für Legacy-Slug-Varianten und stillgelegte Seiten.
- Validierungsskripte, die den Build-Output gegen das Produktionsinventar diffen (gefordertes Ergebnis: null fehlende erwartete URLs) und jeden internen Link prüfen (gefordertes Ergebnis: null tote Links).
Ein ehrlicher Vorbehalt: „Null SEO-Verlust” bedeutet hier technische Kontinuität - identische URLs, hreflang, Meta und Redirects. Über Suchrankings entscheiden Suchmaschinen im Laufe der Zeit; wir haben die Bedingungen konstruiert, nicht das Ergebnis.
Wie die Politurphase in Zahlen aussah
Die späteren Verfeinerungs-Workflows liefen mit vollständiger Telemetrie, was ein selten konkretes Bild davon liefert, was Multi-Agenten-Arbeit tatsächlich kostet. Ein Run - die Wiederherstellung verlorener Inline-CSS-Blöcke plus ein Audit der gesamten Seite auf ähnliche Probleme - nutzte 12 Agenten über 19,3 Minuten Wall-Clock-Zeit (Spitze: 5 parallel) und mischte Modelle je nach Aufgabe: schnelle Modelle für die Ausführung, stärkere Modelle für Vision-QA und den schwierigsten JavaScript-Port. Ein anderer - die Umsetzung der PageSpeed-Empfehlungen - nutzte 6 Agenten über 27,9 Minuten: fünf arbeiteten auf disjunkten Dateien (Fonts, Bilder, CSS-Splitting, LCP, Cache-Header) plus ein Verifikator mit lokalen Lighthouse-Audits.
Das Ergebnis des zweiten Runs: PageSpeed mobil Performance 99, Accessibility 91, Best Practices 81, SEO 92.
Über die gesamte Politurphase verarbeiteten die Agenten 29,2 Millionen Tokens und machten 591 Tool-Aufrufe, dazu 268 in den Hauptsessions - insgesamt 859 Tool-Aufrufe in rund 104 Agenten-Minuten paralleler Arbeit.
Das neue Bearbeitungsmodell: ein Prompt statt eines CMS
Die Migration hat mehr verändert als den Stack - sie hat verändert, wer die Website bearbeiten kann und wie:
- Prompt in Claude Code Web (funktioniert auch vom Handy): „Füge einen Blogpost hinzu über…“.
- Branch und PR - Claude erstellt einen Branch und schreibt Markdown, das dem Content-Schema entspricht; ein paketierter Skill kennt den Frontmatter-Vertrag.
- Preview-URL - Cloudflare Workers Builds kompiliert den Branch und postet einen Link zur gerenderten Seite in den PR.
- Review - ein Mensch klickt sich durch die Preview, fordert Änderungen per Prompt an oder gibt frei.
- Merge -> live - grüne CI plus eine Freigabe; der Main-Branch ist geschützt.
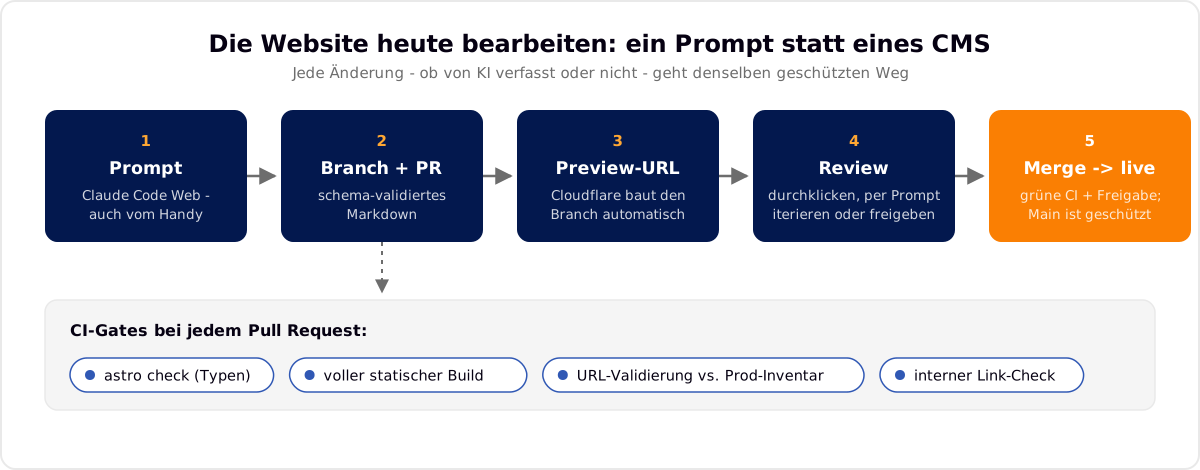
Heute durchläuft jeder Pull Request - ob von KI verfasst oder nicht - dieselben CI-Gates: Type-Checking, ein CSS-Check, ein vollständiger statischer Build, URL-Validierung gegen das Produktionsinventar, ein interner Link-Check und die FAQ-Sync-Prüfung. Und die Cloud-Session sieht ausschließlich das GitHub-Repository: keine Secrets, kein Produktionszugriff. Man kann die Seite nicht per Prompt kaputt machen.
Das einzige verbleibende „Backend” ist ein einzelner Cloudflare-Worker-Endpoint, der die vier Kontaktformulare verarbeitet und Einsendungen mit Turnstile-Antispam an Slack und E-Mail weiterleitet.
Was wir tatsächlich gelernt haben
- Die Constraints haben es möglich gemacht. „Identische Pixel, identische URLs” ist ein verifizierbares Ziel. Verifizierbare Ziele sind genau das, worauf Agenten gut konvergieren.
- Verifikationsschleifen schlagen Vertrauen. Jede Behauptung in diesem Artikel lässt sich auf ein Artefakt im Repository zurückführen: Diff-Berichte, Screenshots, Inventare, CI-Logs. Die Agenten wurden nie gebeten, Recht zu haben - sie wurden gebeten, es zu beweisen.
- Root Causes haben Hebelwirkung. Ein CSS-Fix, der 231 Seiten repariert, ist der Unterschied zwischen einem Agentenschwarm, der konvergiert, und einem, der sich festfährt.
- Die Rolle des Menschen verschiebt sich, sie verschwindet nicht. Die rund neunzig Prompts über das Projekt hinweg waren Entscheidungen: was gebaut wird, was als fertig gilt, was live geht. Alles dazwischen war Ausführung, Verifikation und Berichterstattung.
Und ein letzter Beleg: Genau dieser Artikel wurde per Prompt in Claude Code Web geschrieben, lief über einen Branch, einen PR, eine Preview-URL und ein menschliches Review - exakt der Workflow, den er beschreibt.